

Этот отчёт посвящён открытому файлу из 10 000 симулированных краш-коэффициентов. Строки получены из публичных сидов и последовательных значений nonce с помощью HMAC-SHA256. Они не записаны в Aviator, Lucky Jet, Stake или другом казино. В файле нет временных меток, ставок игроков, запросов кэшаута и платёжных записей. Эти ограничения определяют, на какие вопросы данные способны ответить.
Проверяемый отчёт позволяет заново получить каждое опубликованное число. Здесь распределение, длины серий и результаты фиксированных ставок рассчитаны по одному CSV. Повторное вычисление хэша проверяет соответствие указанным входным данным. Оно не превращает синтетические строки в реальные наблюдения и не сертифицирует коммерческую игру. Отдельный калькулятор Aviator использует SHA-512 и четыре сида. Поэтому называть этот HMAC-файл аудитом раундов Aviator неверно.
1. Состав файла и порядок воспроизведения
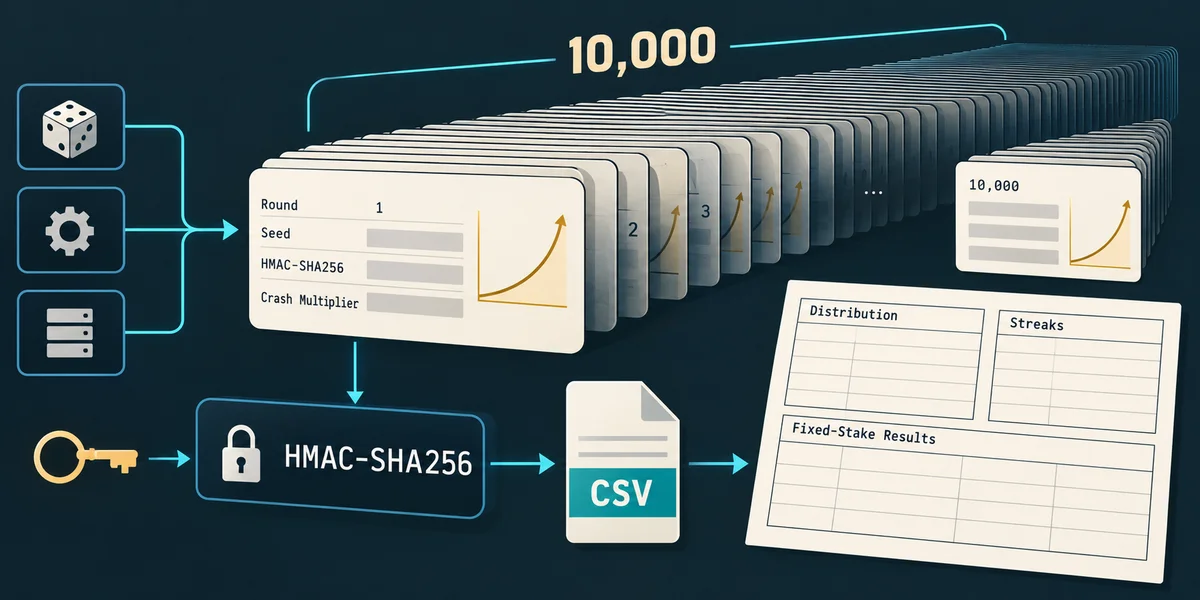
В таблице шесть столбцов: round_id, server_seed, client_seed, nonce, hmac_sha256 и multiplier. Всего 10 000 строк данных. Во всех строках используется один и тот же публичный текст серверного и клиентского сидов, а nonce принимает значения от 1 до 10 000. Для расчёта серий и автокорреляции нужно сохранить исходный порядок. Сортировка по величине коэффициента отвечает на другой вопрос и разрушает последовательность наблюдений.
Для каждой строки вычисляется HMAC-SHA256, где ключом служит серверный сид, а сообщением является точная строка UTF-8 client_seed + ':' + nonce. Первые 13 шестнадцатеричных символов преобразуются в целое число I, затем u = I / 2^52. Формула коэффициента в этом наборе: max(1, floor(97 / (1-u)) / 100). Дополнительной проверки остатка по модулю 33 здесь нет. Её добавление создало бы другую модель и наложило бы второе снижение возврата поверх коэффициента 0,97.
Все 10 000 записанных хэшей совпадают с повторным вычислением. Все 10 000 коэффициентов соответствуют указанному преобразованию. Это результат проверки воспроизводимости конкретного файла. Поскольку сиды уже открыты, проверка ничего не сообщает о сохранении будущего игрового результата в тайне. Описание набора, машиночитаемая сводка и эталонный расчёт на Python позволяют повторить работу без ставки и без подключения к игровому счёту.
Сиды обрабатываются именно как текст, а не как декодированные байты шестнадцатеричного числа. Регистр символов, разделитель и порядок частей сообщения имеют значение. Проверка другого сообщения может дать корректный криптографический хэш, который всё равно не относится к нужной строке. Поэтому сначала фиксируют входные данные, затем проверяют алгоритм и только после этого сравнивают коэффициент.
2. Сводная статистика: медиана не равна доходности кэшаута
| Метрика | Значение |
|---|---|
| Строки | 10000 |
| Воспроизведённые HMAC-хэши | 10000 |
| Результаты на 1,00x | 396 (3,96%) |
| Медиана | 1,88x |
| Среднее арифметическое | 7,27652x |
| Максимум | 4109,28x |
| Результаты ≥ 2x | 4711 |
| Результаты ≥ 10x | 982 |
| Результаты ≥ 100x | 81 |
Медиана равна 1,88x: половина упорядоченных наблюдений находится по одну сторону от центральной пары, половина по другую. Среднее арифметическое равно 7,27652x, поскольку редкие крупные значения поднимают его вверх. Ни одна из этих величин не означает, что игрок способен регулярно забирать ставку на таком коэффициенте. Фиксированная цель оплачивается только при её достижении, а доходность должна учитывать каждую проигранную ставку.
Максимум файла равен 4 109,28x и находится в строке 3 844. Это одно наблюдение синтетической последовательности, а не выплата, подтверждённая казино, и не предельный множитель оператора. Большой коэффициент также не сообщает, какую ставку приняли бы в игре и действовал ли бы лимит выплаты. Таких полей в CSV нет. Распределение коэффициентов, чистый результат выбранной ставки и движение доступного банка являются разными объектами анализа.
Тяжёлый хвост объясняет, почему среднее заметно меняется между конечными выборками. Идеальная непрерывная модель без верхней границы и конечная реализация на 52 битах не совпадают как математические объекты. В реальной игре могут дополнительно действовать ограничения. Среднее этого файла нельзя объявлять бесконечной теоретической выплатой. Другая последовательность из 10 000 строк не обязана иметь такой же максимум или похожее среднее.
3. Девять непересекающихся диапазонов коэффициента
| Диапазон коэффициента | Строки | Доля |
|---|---|---|
| 1,00x | 396 | 3,96% |
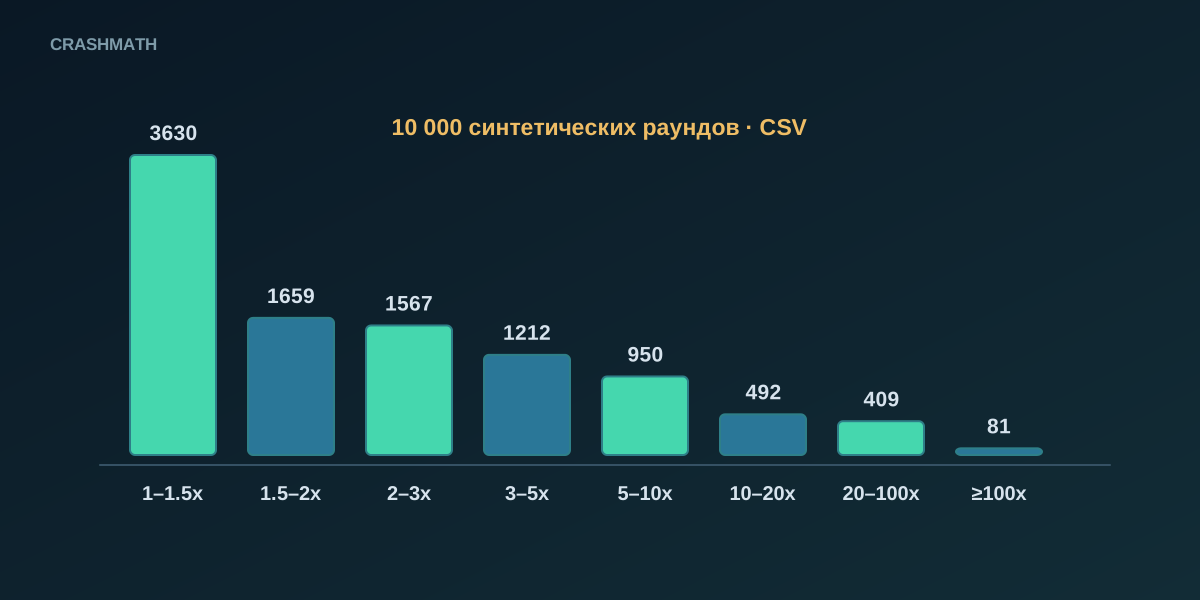
| 1,01-1,49x | 3234 | 32,34% |
| 1,50-1,99x | 1659 | 16,59% |
| 2,00-2,99x | 1567 | 15,67% |
| 3,00-4,99x | 1212 | 12,12% |
| 5,00-9,99x | 950 | 9,50% |
| 10,00-49,99x | 817 | 8,17% |
| 50,00-99,99x | 84 | 0,84% |
| 100+x | 81 | 0,81% |
Девять диапазонов включают ровно 10 000 строк и 100% выборки. Нижняя граница входит в диапазон, а нижняя граница следующего диапазона в него уже не входит. Поэтому 1,50x относится к группе 1,50–1,99, а 2,00x относится к группе 2,00–2,99. Первая группа содержит только показанный коэффициент 1,00x. Явные границы нужны, чтобы гистограмма и число выигрышей при фиксированном кэшауте не расходились из-за разных определений.
В файле 396 результатов на 1,00x, то есть 3,96%. Это не измерение отдельного механизма мгновенного проигрыша с маржой 3%. При используемом преобразовании все исходные значения меньше 1,01 после округления вниз и применения нижнего предела превращаются в 1,00. Для идеального равномерного u вероятность такого интервала равна 1 - 0.97/1.01 = 4/101, приблизительно 3,960396%. Наблюдаемая доля близка к этому ожиданию, но каждая конечная выборка не обязана точно повторять теоретическую пропорцию.
Проверка согласия должна использовать дискретную модель с округлением и заранее определённый статистический метод. Сравнение с непрерывной функцией распределения, игнорирующей массу в точке 1,00x, может дать ошибочную интерпретацию. Новый p-value критерия хи-квадрат здесь не приводится. Даже отсутствие оснований отвергнуть распределение не доказывало бы надёжность сидов, наличие обязательства до раунда или отсутствие манипуляции со стороны оператора.
Число результатов не ниже заданной цели удобно проверять суммированием подходящих диапазонов. Например, для 10x нужно сложить группы 10,00–49,99, 50,00–99,99 и 100+. Получается 817 + 84 + 81 = 982 строки. Это та же величина, которая используется в таблице фиксированных ставок ниже. Такая сверка связывает две таблицы одним проверяемым правилом.
4. Что показывают зарегистрированные серии
| Определение серии | Максимум строк подряд |
|---|---|
| Ниже 2x | 13 |
| Не ниже 2x | 12 |
| Ровно 1,00x | 2 |
| Ниже 10x | 79 |
При цели 2,00x проигрыш означает коэффициент строго ниже 2,00x. Равенство цели считается выигрышем в этом расчёте. Самая длинная серия таких проигрышей содержит 13 строк, а самая длинная серия выигрышей содержит 12. Максимальный блок значений 1,00x состоит из двух строк. Самый длинный промежуток без достижения 10x равен 79 строкам. Каждый максимум зависит от определения события, длины последовательности и конкретных сидов этого файла.
Вероятность проиграть следующие m независимых ставок равна q^m, если q обозначает заданную вероятность проигрыша. Это другая величина, чем вероятность встретить хотя бы одну такую серию где-либо внутри 10 000 ставок: перекрывающиеся окна используют общие наблюдения. Также это не средняя длина максимальной серии. Подмена одной величины другой создаёт чрезмерную уверенность в том, сколько способен выдержать выбранный банк.
Отдельный арифметический пример: удвоение ставки с одной единицы после каждого проигрыша расходует 1 + 2 + ... + 4 096 = 8 191 единицу за 13 поражений подряд. Банк 1 000 единиц такую последовательность не финансирует. Корректная симуляция должна остановиться перед недоступной следующей ставкой либо прямо задать меньшую последнюю ставку. Само наличие серии в файле не устанавливает точный номер разорения каждой сессии по мартингейлу.
Наблюдаемый максимум также не является верхним пределом будущей серии. Значение 13 описывает только эти строки. Оно не означает, что четырнадцатый проигрыш запрещён алгоритмом или что после тринадцатого вероятность выигрыша возрастает. Для прогноза следующего независимого события длина уже увиденной серии не заменяет исходную вероятность модели.
5. Фиксированная ставка в одну единицу на той же последовательности
Следующие расчёты начинаются с банка 1 000 единиц и используют ровно одну единицу на строку. Цель выбирается до начала последовательности. Выигрыш возвращает ставку плюс k-1 единиц чистой прибыли, проигрыш списывает одну единицу. Во всех пяти расчётах денег хватает на каждую следующую ставку. Комиссии, бонусы, ошибки времени и ограничения оператора не моделируются. Единицы являются расчётными, а не наблюдаемыми долларами и не балансами клиентов.
| Цель | Выигрыши | Чистый итог, единицы | Конечный банк | Минимальный банк |
|---|---|---|---|---|
| 1,50x | 6370 | -445,00 | 555,00 | 543,00 |
| 2,00x | 4711 | -578,00 | 422,00 | 407,00 |
| 3,00x | 3144 | -568,00 | 432,00 | 390,00 |
| 5,00x | 1932 | -340,00 | 660,00 | 586,00 |
| 10,00x | 982 | -180,00 | 820,00 | 626,00 |
Например, при цели 2x получено 4 711 выигрышей и 5 289 проигрышей. Чистый итог равен 4 711 × 1 - 5 289 = -578 единиц, поэтому от начальных 1 000 остаётся 422. Минимальный банк по ходу последовательности равен 407. Этот минимум не равен максимальной просадке от прежнего пика. Если назвать одну метрику другой, описание траектории станет неверным даже при правильном конечном балансе.
Все пять целей на этом файле заканчивают с убытком, но он не равен ровно 3% оборота. Для 10 000 ставок по одной единице ожидание идеальной модели составляет -300 единиц, тогда как фактические итоги различаются. Здесь цель 10x потеряла меньше, чем 1,5x. Выбор 10x после просмотра таблицы был бы отбором по прошлому результату, а не доказательством лучшего будущего ожидания. Цели используют одну последовательность, поэтому это не пять независимых экспериментов.
Оборот во всех пяти случаях одинаков: 10 000 единиц. Начальный банк не является оборотом. Например, потеря 578 единиц составляет 5,78% оборота и одновременно 57,8% исходного банка. Обе доли верны, но отвечают на разные вопросы. Сравнивая стратегии, нужно прямо указывать знаменатель, размер ставки, горизонт и правило остановки, иначе одинаковые числа создают разные впечатления о риске.
6. Автокорреляция как описание выборки
| Лаг | Выборочный коэффициент |
|---|---|
| 1 | -0,00106853 |
| 2 | -0,00255805 |
| 3 | -0,00223775 |
| 5 | -0,00177960 |
| 10 | -0,00354494 |
Коэффициенты вычислены по исходным множителям и их выборочному среднему. В знаменателе используется сумма квадратов отклонений по всем 10 000 значениям. В таблице сохранены восемь знаков после запятой. Для перечисленных лагов коэффициенты малы, но малый выборочный коэффициент не доказывает точную независимость. Тяжёлые хвосты, другие преобразования данных и выбор самих лагов влияют на интерпретацию диагностической проверки.
К этим исходным значениям не приписывается универсальная доверительная граница ±1,96/√N. Лавинный эффект хэша также не объявляется доказательством статистической независимости. Для исследования предсказателя нужны правило, установленное до проверки, нетронутые будущие наблюдения, полный журнал прогнозов с ошибками и расчёт чистой доходности. Повторное исследование детерминированной последовательности с открытыми сидами не является проверкой на будущих закрытых входах живой игры.
7. Почему файл не проверяет «платящие часы»
Номер строки и nonce являются счётчиками, а не временными метками. Столбца с датой или временем в CSV нет. Поэтому невозможно построить настоящие группы утренних, вечерних или четырёхчасовых наблюдений по UTC. Если присвоить строкам искусственное время, получится выдуманная переменная, влияние которой якобы исследуется. Измеренного суточного цикла RTP и сравнения задержек устройств в этом отчёте нет.
Настоящее исследование времени суток сначала определило бы версию игры, часовой пояс, период сбора, цель кэшаута, обработку ставок и пропусков. Понадобились бы наблюдения со временем, позволяющие отделить изменение поведения игроков от изменения процесса генерации коэффициентов. Даже найденное различие потребовало бы оценки неопределённости и будущей проверки перед практическим выводом. Никакое переименование этой симуляции не создаёт отсутствующие доказательства.
8. Загрузка, проверка и интерпретация
Скачайте исходный CSV из 10 000 строк и сохраните его байты неизменными. Сначала пересчитайте хэши, затем округлённые коэффициенты, гистограмму и последовательные балансы. Убедитесь, что диапазоны дают полное число строк, а у каждой цели согласуются выигрыши, проигрыши, оборот и итоговый банк. Эти простые равенства обнаруживают ошибки, которые не исправит впечатляющий p-value.
Терминал Monte Carlo строит другую случайную траекторию при запуске. Его итог не является результатом этого фиксированного файла. Калькулятор хэшей также отделяет расчёт Aviator от иллюстративных примеров HMAC. Для проверки коммерческого раунда нужны его записанные входы и точный протокол игры. Эти результаты подходят для воспроизводимого обсуждения математики, но не являются прогнозом, сертификацией платформы или обещанием безопасной игры.